
Warum XCP-ng und XenServer zusammengehören
XCP-ng ist aus dem quelloffenen Teil von XenServer entstanden und verwendet dieselbe Verwaltungsschicht: XAPI, Storage Repositories als Speichercontainer und virtuelle Festplatten im VHD-Format. Für eine Wiederherstellung heißt das, dass wir in beiden Welten mit denselben Strukturen arbeiten.
Zum Stand: XCP-ng 8.2 als Langzeitfassung hat im September 2025 das Ende seiner Unterstützung erreicht, für die aktuelle Linie ist Support bis Ende November 2028 zugesagt. Bei XenServer steht mit Version 9 ein neuer Stand als Vorschau bereit, und die dateibasierte Lizenzierung läuft im April 2026 aus. Beides zusammen bringt gerade viele Umgebungen in Bewegung, und Umzüge sind erfahrungsgemäß die Phase, in der Sicherungen unvollständig sind.

Die Snapshot-Kette und das Zusammenführen
Ein Snapshot legt in einem Storage Repository nicht eine, sondern zwei virtuelle Datenträger an. Im Hintergrund führt die Plattform die entstandene Kette später wieder zusammen. Dieser Vorgang heißt Coalesce und braucht dafür freien Platz im Repository.
- Läuft das Repository voll, kann nicht mehr zusammengeführt werden, und die Kette wächst
- Die Kettenlänge ist auf 30 Glieder begrenzt; darüber verweigert die Plattform weitere Snapshots
- Ein abgebrochener Durchlauf hinterlässt verwaiste Datenträger
- Laufende Sicherungsaufträge legen ständig neue Snapshots an und verschärfen die Lage
Erste Maßnahme im Schadensfall ist deshalb, alle Sicherungsaufträge abzuschalten. Danach schaffen Sie Platz im Repository, ohne etwas zu löschen, das zur Kette gehört. Welche Datei zu welchem Glied gehört, ist von außen nicht zuverlässig zu erkennen; im Zweifel warten Sie mit dem Aufräumen, bis der Zustand gesichert ist.
Wenn Aufgaben endlos hängen
Ein in der Dokumentation beschriebenes Fehlerbild lautet sinngemäß, dass Aufgaben und Befehle hängen bleiben oder extrem langsam laufen. Als Ursachen werden dort ein degradierter RAID-Verbund, ausfallende Laufwerke und langsamer Speicher genannt. Das ist ein wichtiger Hinweis: Was wie ein Problem der Virtualisierung aussieht, ist häufig ein Hardwareproblem eine Ebene tiefer.
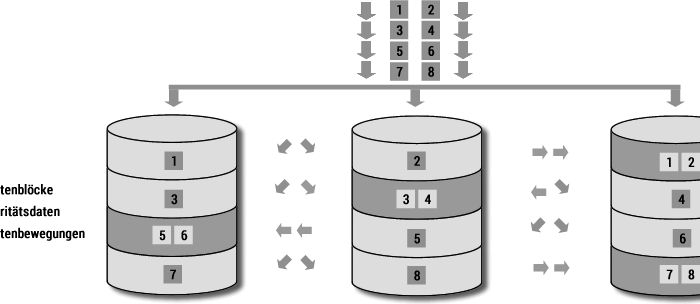
Prüfen Sie in dieser Situation zuerst den Zustand des Verbundes und die Protokolle der Speicherverwaltung. Beginnt ein Laufwerk gerade auszufallen, ist jeder weitere Zugriffsversuch riskant. Wie wir dann vorgehen, steht auf der Seite zur RAID-Datenrettung.
Was bei großen virtuellen Festplatten zu beachten ist
Virtuelle Datenträger über 2 TiB lassen sich nicht auf jedem Weg exportieren; hier bleibt der Export als XVA-Archiv. Das ist im Notfall wichtig zu wissen, weil ein gewohnter Exportweg dann schlicht nicht zur Verfügung steht. Planen Sie den Rückweg Ihrer Daten mit ein, bevor Sie mit der Wiederherstellung beginnen.
Was den Schaden vergrößert
- Sicherungsaufträge weiterlaufen lassen. Jeder neue Snapshot verlängert die Kette, die ohnehin nicht zusammengeführt werden kann.
- Vermeintlich verwaiste Datenträger löschen, um Platz zu schaffen. Gehört die Datei doch zur Kette, ist die Maschine danach nicht mehr herstellbar.
- Den Host neu starten, solange Aufgaben hängen. Der Laufzeitzustand geht verloren, und beim Start beginnen Prüf- und Aufräumvorgänge.
- Auf der Ebene darunter ein RAID neu aufbauen. Der Wiederaufbau läuft über die Bereiche, in denen die virtuellen Festplatten liegen.
- Das Repository neu anlegen, weil es nicht mehr eingebunden wird. Damit ist der Inhalt endgültig verloren.
Sichern Sie stattdessen den Zustand und lassen Sie ihn prüfen. Die telefonische Erstberatung ist kostenlos und klärt in wenigen Minuten, ob ein Schritt sicher ist.
Was wir für die Analyse brauchen
- Alle Laufwerke des Verbundes, auf dem das Repository liegt, mit Positionsangabe
- Angabe zur Plattform und Version sowie zum Typ des Repositories
- Ob und wann ein Zusammenführen abgebrochen ist
- Was seit dem Ausfall bereits unternommen wurde

- Eigenes Reinraumlabor & Ersatzteillager
- 95% Datenrettungsgarantie
- Qualitätssicherung nach ISO 9001:2015
- Diskretion & Datenschutz nach DSGVO
- Persönlicher Ansprechpartner
 Datenrettung anfragen
Fragen und Antworten
In der Regel nicht. Die virtuellen Festplatten liegen weiterhin auf den Laufwerken, es fehlt der Zugriff auf die Verwaltungsebene. Legen Sie auf keinen Fall ein neues Repository auf demselben Speicher an, das würde die vorhandenen Strukturen überschreiben.
Meist fehlt Platz im Repository, oder die darunterliegenden Laufwerke liefern nicht zuverlässig. Schalten Sie zuerst alle Sicherungsaufträge ab, damit keine neuen Snapshots hinzukommen, und prüfen Sie den Zustand des Verbundes, bevor Sie einen weiteren Versuch starten.
Wenn die Datei vollständig vorliegt und kein Glied der Kette fehlt, ja. Fehlt ein Glied, lässt sich meist der Stand bis zu diesem Punkt rekonstruieren. Deshalb ist es wichtig, alle Dateien der Kette unverändert zu sichern, auch die scheinbar überflüssigen.
Ja. Gerade während einer Migration häufen sich Ausfälle, weil die Sicherungskette noch nicht eingespielt ist und die alte Umgebung teils schon abgebaut wurde. Wir sehen uns Quelle und Ziel zusammen an, das ist meist der schnellere Weg.
Der Preis richtet sich nach der Zahl der Datenträger und dem Schaden. Nach der Analyse erhalten Sie ein Festpreisangebot und entscheiden erst dann. Vertraglich zugesichert sind mindestens 95 Prozent der wiederherstellbaren Daten.
Ihre Virtualisierung gibt keine Daten mehr frei? Nennen Sie uns die Plattform, den Typ des Repositories und was zuletzt geschehen ist. Wir sagen Ihnen, was jetzt sinnvoll ist. Verwandte Seiten: Übersicht virtuelle Maschinen, Proxmox und VMware.